Monitoring konvensional sering kali kesulitan mengidentifikasi akar masalah pada arsitektur enterprise yang mengandalkan ribuan pod Kubernetes dan lingkungan multi-cloud. Data performa yang tersebar di berbagai tools membuat tim IT sulit menghubungkan gangguan infrastruktur dengan masalah aplikasi. Akibatnya, proses investigasi insiden dapat memakan waktu lebih lama dan meningkatkan risiko terganggunya service-level agreement (SLA).
Full stack observability enterprise menjadi pendekatan yang relevan untuk menghadapi kompleksitas tersebut. Namun, apa yang membuat monitoring tradisional kurang efektif dalam lingkungan terdistribusi, dan bagaimana perusahaan dapat menjaga performa aplikasi sekaligus memenuhi SLA bisnis?
Monitoring Tradisional Mulai Kewalahan
Monitoring tradisional umumnya membantu tim IT mengetahui kondisi komponen tertentu, seperti utilisasi CPU, kapasitas memori, atau status server. Namun, mengetahui bahwa sebuah komponen mengalami anomali tidak selalu menjelaskan mengapa transaksi pengguna melambat atau layanan bisnis mengalami gangguan. Tantangan ini semakin terasa ketika aplikasi terdiri dari banyak microservices yang berjalan di lingkungan cloud dan container dinamis.
Data Silo, Investigasi Semakin Lama
Ketika metrik infrastruktur, log aplikasi, dan data performa jaringan berada dalam dasbor yang berbeda, tim IT harus mengumpulkan informasi dari berbagai sumber sebelum memahami situasi yang sebenarnya. Kondisi ini menciptakan monitoring silo dan meningkatkan beban investigasi, terutama ketika beberapa komponen menunjukkan gejala gangguan pada waktu yang bersamaan.
Tanpa korelasi data yang memadai, tim dapat menghabiskan waktu untuk memeriksa gejala satu per satu, padahal akar masalahnya mungkin berasal dari satu layanan atau dependensi tertentu.
MTTR Tinggi, SLA Terancam
Mean Time to Resolve (MTTR) mengacu pada waktu rata-rata yang dibutuhkan untuk menyelesaikan suatu insiden. Semakin lama proses investigasi dan pemulihan, semakin besar pula potensi gangguan terhadap transaksi, produktivitas operasional, dan pengalaman pelanggan. Pada layanan yang bergantung pada ketersediaan aplikasi, keterlambatan penanganan dapat meningkatkan risiko tidak tercapainya SLA.
Tiga Pilar Full Stack Observability Enterprise
Full stack observability tidak berhenti pada pengumpulan data performa. Pendekatan ini menghubungkan telemetri dari aplikasi, infrastruktur, dan pengalaman pengguna agar tim IT memahami bagaimana setiap komponen memengaruhi layanan secara keseluruhan. Bagi perusahaan enterprise, visibilitas terpadu ini menjadi fondasi untuk mengelola kompleksitas sistem dan mengambil keputusan operasional secara lebih tepat.
1. APM dan Distributed Tracing
Application Performance Monitoring (APM) membantu tim memantau performa aplikasi, mengidentifikasi bottleneck, dan mengevaluasi kondisi layanan. Ketika dipadukan dengan distributed tracing, tim dapat menelusuri perjalanan transaksi dari permintaan pengguna dan pemanggilan API hingga pemrosesan di backend dan basis data, sehingga lebih mudah mengidentifikasi bagian alur pemrosesan yang menyebabkan keterlambatan dan penurunan performa aplikasi.
2. Real User Monitoring
Performa aplikasi yang terlihat normal dari sisi infrastruktur belum tentu menjamin pengalaman pengguna yang optimal. Pengguna mungkin tetap menghadapi halaman yang lambat, interaksi tertunda, atau transaksi yang tidak berjalan sesuai harapan. Real User Monitoring (RUM) membantu perusahaan memantau performa berdasarkan interaksi pengguna nyata dan menghubungkannya dengan kondisi sistem, sehingga tim dapat mengidentifikasi hambatan yang memengaruhi pengalaman digital, termasuk pada aplikasi perbankan digital dan platform e-commerce.
3. Kubernetes dalam Satu Visibilitas
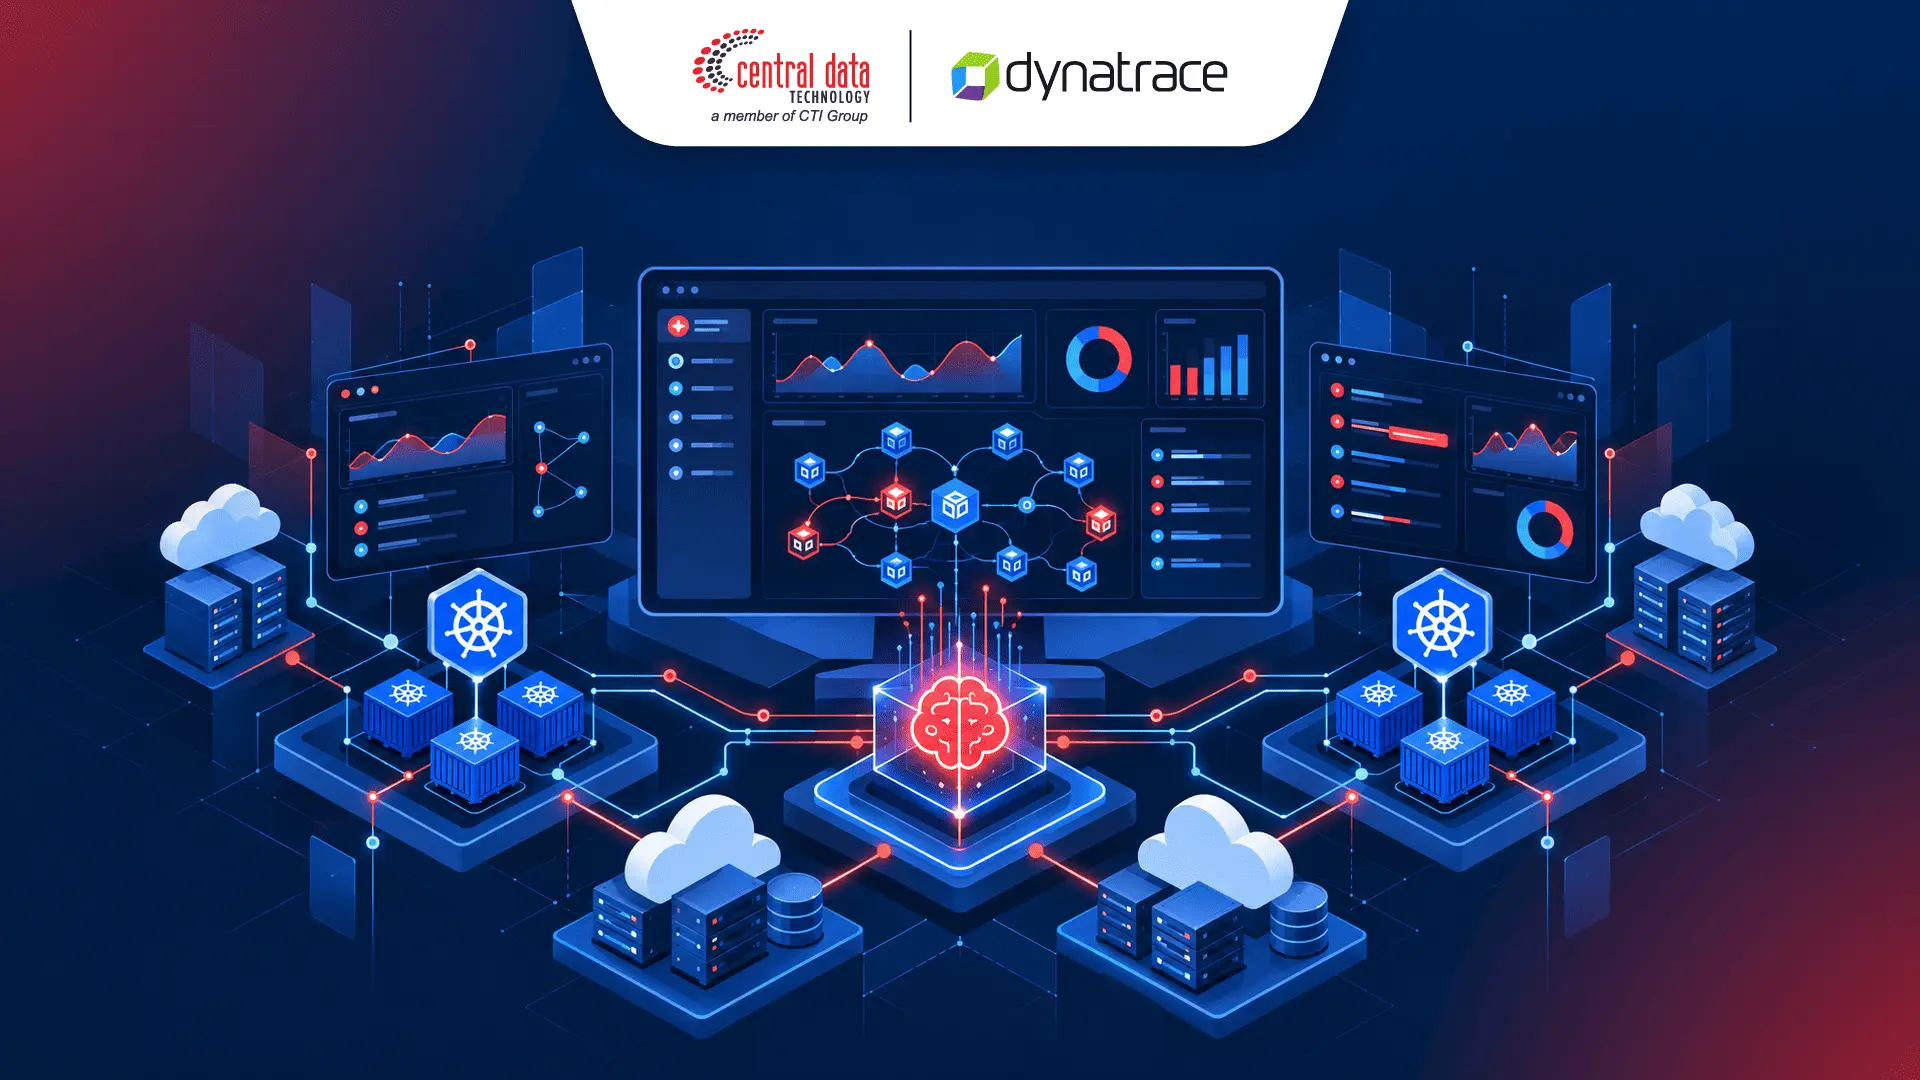
Arsitektur berbasis Kubernetes memungkinkan aplikasi berkembang secara dinamis melalui container dan workload yang menyesuaikan kebutuhan, tetapi perubahan komponen selama deployment dan penyesuaian kapasitas juga membuat pemantauan semakin kompleks. Full stack observability membantu tim memantau kesehatan cluster, container, workload, dan aplikasi secara terpadu melalui penemuan komponen serta pemetaan dependensi otomatis, sehingga visibilitas tetap terjaga di lingkungan cloud-native yang terus berubah tanpa bergantung pada pemetaan manual yang mudah usang.
Dynatrace, AI untuk Menemukan Akar Masalah Lebih Cepat
Ketika gangguan terjadi, tantangan terbesar sering kali bukan menemukan adanya anomali, melainkan memahami penyebabnya di tengah banyaknya komponen dan notifikasi. Sistem yang kompleks dapat menghasilkan berbagai peringatan dalam waktu berdekatan, sehingga tim kesulitan membedakan gejala sekunder dari masalah yang benar-benar perlu ditangani terlebih dahulu.
Dynatrace mendukung proses investigasi melalui korelasi data, pemetaan dependensi, dan kemampuan AI untuk membantu mengidentifikasi kemungkinan akar masalah. Dengan pendekatan ini, tim dapat beralih dari pemeriksaan manual yang terfragmentasi menuju analisis yang mempertimbangkan hubungan antarkomponen dan dampak gangguan terhadap layanan.
OneAgent dan Smartscape, Petakan Dependensi Otomatis
Dynatrace OneAgent mengumpulkan data observabilitas dari komponen teknologi yang didukung, sementara Smartscape memetakan topologi untuk menggambarkan hubungan antara aplikasi, layanan, dan infrastruktur. Kombinasi keduanya membantu tim memahami keterkaitan antarkomponen serta dampak gangguan pada satu bagian terhadap bagian lainnya.
Dengan pemetaan dependensi otomatis, perusahaan juga dapat mengurangi ketergantungan pada dokumentasi manual yang perlu terus diperbarui, sehingga informasi mengenai topologi dan hubungan layanan tetap relevan untuk mempercepat penelusuran insiden di lingkungan enterprise yang terus berubah.
Davis AI, Dari Alert ke Akar Masalah
Davis AI membantu menganalisis data observabilitas untuk mengidentifikasi anomali, menelusuri kemungkinan penyebab, dan memberikan konteks terhadap gangguan yang terjadi. Alih-alih memperlakukan setiap peringatan sebagai masalah terpisah, pendekatan ini membantu tim memahami hubungan antara gejala dan perubahan kondisi sistem.
Bagi tim SRE, DevOps, dan operasional IT, kemampuan tersebut dapat membantu menentukan prioritas investigasi dan mengurangi pekerjaan manual yang berulang. Hasilnya bergantung pada kondisi lingkungan, konfigurasi, dan karakteristik insiden, tetapi analisis yang lebih terarah dapat mendukung upaya menekan MTTR dan menjaga keandalan layanan.
Observability vs. Monitoring Tradisional
Aspek | Monitoring Tradisional | Full Stack Observability Dynatrace |
Deteksi masalah | Mengandalkan metrik dan ambang batas yang dikonfigurasi | Menggabungkan telemetri dan analisis anomali berbasis AI |
Pemetaan dependensi | Dapat memerlukan dokumentasi dan pembaruan manual | Mendukung penemuan serta pemetaan topologi otomatis |
Visibilitas transaksi | Informasi dapat tersebar di berbagai alat | Mendukung penelusuran transaksi lintas layanan melalui distributed tracing |
Analisis akar masalah | Membutuhkan korelasi dan investigasi manual | Membantu mengidentifikasi kemungkinan akar masalah dengan konteks lintas komponen |
Pengelolaan insiden | Tim perlu menyatukan informasi dari berbagai sumber | Membantu memusatkan informasi untuk mendukung investigasi dan penentuan prioritas |
Perbedaan utama antara monitoring tradisional dan full stack observability terletak pada kedalaman konteks yang tersedia untuk memahami masalah. Monitoring membantu menunjukkan kondisi komponen, sedangkan observability menghubungkan berbagai sinyal untuk membantu menjelaskan penyebab gangguan dan dampaknya terhadap layanan.
Implementasi Observability Tanpa Gangguan Operasional
Implementasi full stack observability sebaiknya dimulai dengan mengidentifikasi kebutuhan bisnis dan risiko operasional yang paling kritis. Perusahaan dapat memprioritaskan alur transaksi penting, layanan dengan banyak dependensi, atau aplikasi yang memiliki target SLA ketat.
Selanjutnya, integrasikan data metrik, log, dan traces agar dapat dianalisis dalam konteks yang saling terhubung. Standar seperti OpenTelemetry mendukung integrasi telemetri, sedangkan pemetaan dependensi membantu memahami hubungan antarkomponen. Sesuaikan juga dasbor dengan kebutuhan pengembang, tim SRE, pengelola infrastruktur, dan manajemen.
Agar lebih berdampak, hubungkan hasil pemantauan dengan indikator bisnis, seperti keberhasilan transaksi, responsivitas aplikasi, ketersediaan layanan, dan pencapaian SLA. Dengan konteks data yang sama, tim aplikasi, infrastruktur, dan operasional IT dapat memprioritaskan insiden berdasarkan dampaknya, menyelidiki gangguan, serta merencanakan perbaikan secara lebih terkoordinasi.
FAQ Full Stack Observability Enterprise
Apa perbedaan monitoring tradisional dan full stack observability?
Monitoring tradisional berfokus pada kondisi komponen dan indikator performa tertentu. Full stack observability menghubungkan metrik, log, traces, serta informasi dependensi untuk membantu tim memahami penyebab gangguan dan dampaknya terhadap layanan secara lebih menyeluruh.
Bagaimana Dynatrace membantu mempercepat MTTR?
Dynatrace menggabungkan data observabilitas, pemetaan dependensi, dan kemampuan AI untuk membantu mendeteksi anomali serta mengidentifikasi kemungkinan akar masalah. Informasi tersebut dapat mempersempit area investigasi dan membantu tim menentukan tindakan yang perlu diprioritaskan.
Apakah full stack observability mendukung Kubernetes?
Ya. Dynatrace menyediakan kemampuan pemantauan untuk lingkungan Kubernetes dan cloud-native, termasuk visibilitas terhadap cluster, workload, container, aplikasi, serta hubungan dependensinya. Cakupan yang tersedia bergantung pada komponen dan konfigurasi yang diterapkan.
Apakah implementasi Dynatrace membutuhkan perubahan kode aplikasi?
Dynatrace OneAgent mendukung instrumentasi dan pengumpulan data otomatis untuk berbagai teknologi yang kompatibel, sehingga kebutuhan perubahan kode manual dapat dikurangi. Namun, kebutuhan konfigurasi tambahan tetap bergantung pada teknologi, arsitektur, dan cakupan pemantauan yang diinginkan.
Bangun Visibilitas Aplikasi Enterprise yang Lebih Menyeluruh Bersama CDT
Ketika arsitektur aplikasi semakin kompleks, perusahaan membutuhkan lebih dari sekadar monitoring untuk menjaga performa dan keandalan sistem. Visibilitas menyeluruh membantu tim IT memahami hubungan antara aplikasi dan infrastruktur, mengidentifikasi akar masalah, serta menangani gangguan yang berpotensi memengaruhi operasional bisnis.
Melalui Dynatrace Full-Stack Observability, Central Data Technology (CDT), bagian dari CTI Group, membantu perusahaan meningkatkan visibilitas aplikasi dan infrastruktur melalui pemantauan terpadu serta analisis berbasis AI. Pendekatan ini mendukung investigasi insiden yang lebih terarah dan membantu perusahaan menjaga performa layanan serta pencapaian SLA.
Hubungi tim CDT untuk mengetahui bagaimana solusi full stack observability enterprise dari Dynatrace dapat mendukung kebutuhan dan kompleksitas infrastruktur IT perusahaan Anda.
Penulis: Angela Merici Retna Perwitasari
Content Writer Intern CTI Group